论文发表
更多文章请参见我的 Google Scholar 主页。注:* 表示共同一作;† 表示通讯作者。

Empirical Analysis of Decoding Biases in Masked Diffusion Models
Pengcheng Huang, Tianming Liu, Zhenghao Liu†, Yukun Yan, Shuo Wang, Tong Xiao, Zulong Chen, Maosong Sun
ACL AnthologyarXiv代码项目主页解掩码顺序导读(英文)解码顺序对照预印本全文(HTML)BibTeX
无需训练的解码校准,改善掩码扩散语言模型的系统性解码偏差。
展开摘要
- 本文揭示了掩码扩散模型中基于不确定性解码的两个系统性偏差——刚性边界偏差和无意义词偏差,并提出 Uncode(arXiv 初版名为 PC-Sampler),一个通过位置轨迹先验和语义信息先验重塑解码优先级的轻量级校准框架,平均性能提升超过 7%,达到与同规模自回归模型可比的效果。

ParamMute: Suppressing Knowledge-Critical FFNs for Faithful Retrieval-Augmented Generation
Pengcheng Huang, Zhenghao Liu†, Yukun Yan, Haiyan Zhao, Xiaoyuan Yi, Hao Chen, Zhiyuan Liu, Maosong Sun, Tong Xiao, Ge Yu, Chenyan Xiong
NeurIPSarXiv代码项目主页知识冲突导读(英文)RAG 知识冲突案例预印本全文(HTML)BibTeX
抑制知识关键前馈网络,提升检索增强生成的忠实性。
展开摘要
- 本文提出 ParamMute(arXiv 初版名为 PIP-KAG),通过识别并抑制与不忠实生成相关的前馈网络(FFN),并引入知识偏好适配模块,有效引导语言模型更好地利用检索到的证据,提升检索增强生成的忠实性。
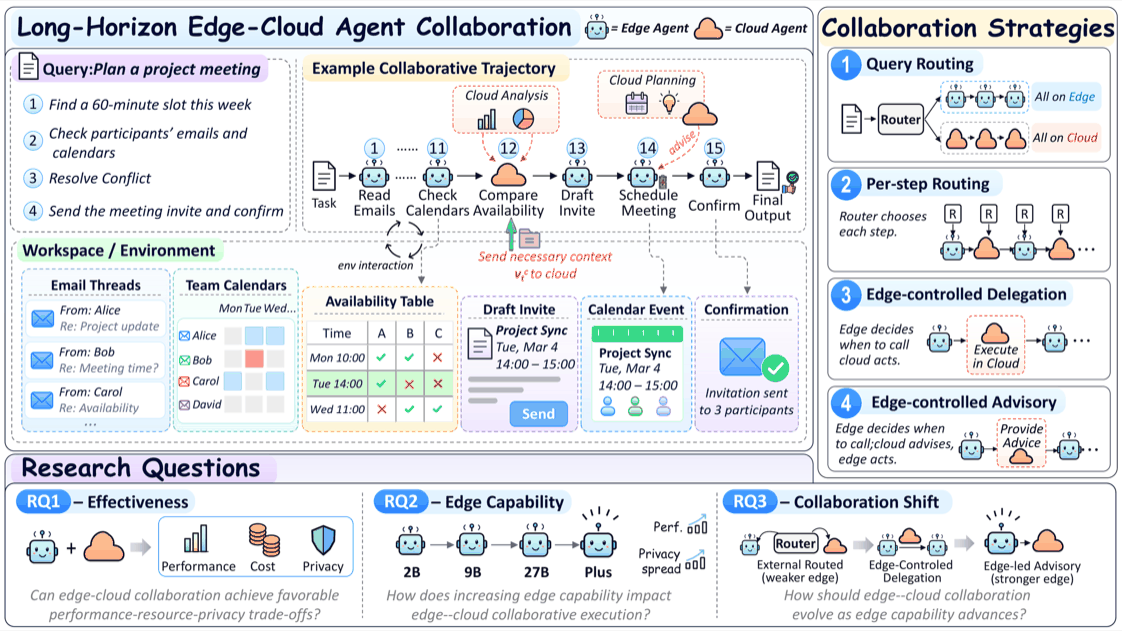
Empowering Edge Agents: A Systematic Analysis of Edge-Cloud Collaboration in LLM Agent Execution
Pengcheng Huang, Zhenghao Liu†, Shixin Ren, Shi Yu, Sijia Yao, Yukun Yan†, Chaojun Xiao†, Maosong Sun
arXiv代码项目主页数据集端云路由对照预印本全文(HTML)BibTeX
系统分析端侧智能体何时求助云端,以及双方如何协作。
展开摘要
- 本文提出 EC²-Bench(EC2-Bench),一个面向长程大模型智能体端云协同的基准,包含 128 个可执行的数字工作区任务(其中 100 个带隐私标注),同时评测任务表现、资源用量和隐私暴露。研究发现:端云协同能在三者之间取得更好的平衡;端侧模型越强,各策略的性能差距越小,隐私差距却没有缩小;随着端侧能力提升,更优的协同方式从外部路由转向端侧主导的云端咨询。
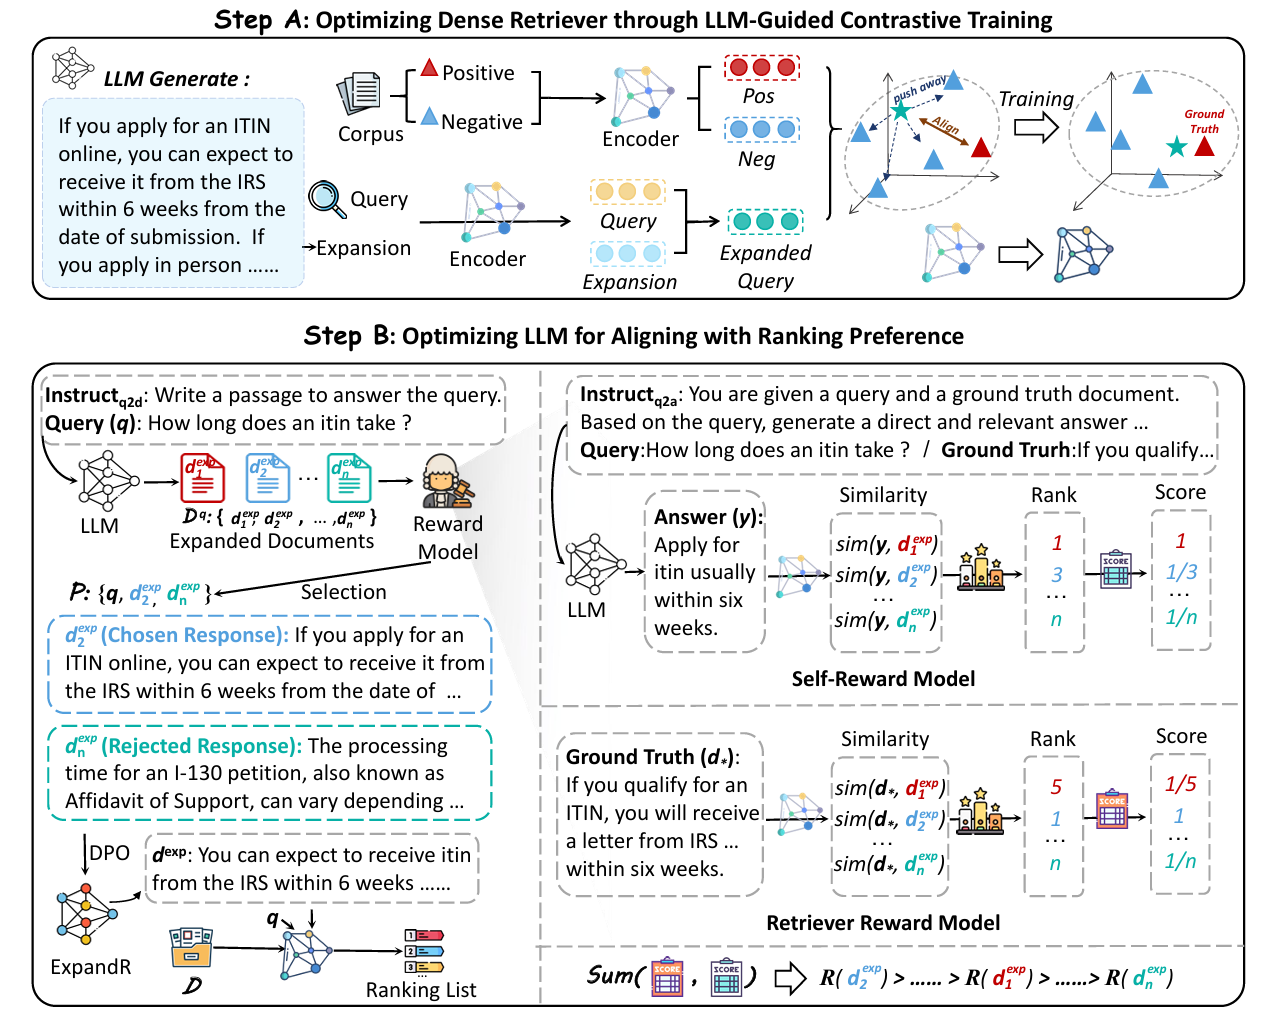
ExpandR: Teaching Dense Retrievers Beyond Queries with LLM Guidance
Sijia Yao*, Pengcheng Huang*, Zhenghao Liu†, Yu Gu, Yukun Yan, Shi Yu, Ge Yu
论文arXiv代码项目页查询扩展对照预印本全文(HTML)BibTeX
在大语言模型指导下联合优化查询扩展与稠密检索。
展开摘要
- 本文提出 ExpandR,一个联合训练大语言模型和稠密检索器的统一框架,通过让 LLM 生成丰富的查询扩展,并同时优化扩展生成和检索排序性能,在检索基准上比强基线提升超 5%。

Chunks as Arms: Multi-Armed Bandit-Guided Sampling for Long-Context LLM Preference Optimization
Shaohua Duan*, Pengcheng Huang*, Xinze Li*, Zhenghao Liu†, Xiaoyuan Yi, Yukun Yan, Shuo Wang, Yu Gu, Ge Yu, Maosong Sun
ACL AnthologyarXiv v2代码项目页长上下文采样对照预印本全文(HTML)BibTeX
以多臂老虎机策略采样长上下文偏好数据。
展开摘要
- 本文提出 LongMab,将长上下文分块视为多臂老虎机的臂,通过 UCB 引导的采样策略渐进识别最具信息量的分块组合,生成高质量多样化响应并构建偏好对用于 DPO 训练,在 Llama 和 Qwen 上平均提升超 4%。
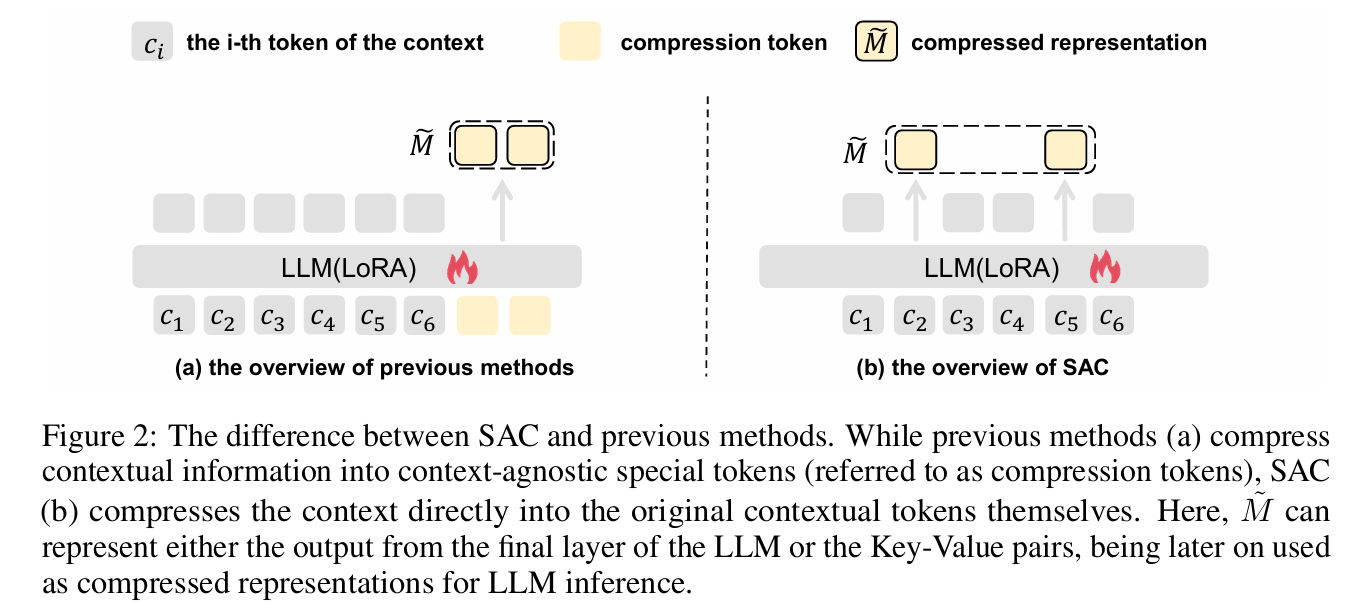
Autoencoding-free context compression for llms via contextual semantic anchors
Xin Liu*, Runsong Zhao*, Pengcheng Huang, Xinyu Liu, Junyi Xiao, Chunyang Xiao, Tong Xiao†, Shengxiang Gao, Zhengtao Yu, Jingbo Zhu
通过上下文语义锚点实现高效的上下文压缩。
展开摘要
- 本文提出语义锚点压缩(SAC),一种无需自编码训练的上下文压缩方法,通过直接选择并聚合信息到上下文”锚点词”中,实现高效的大语言模型上下文压缩。
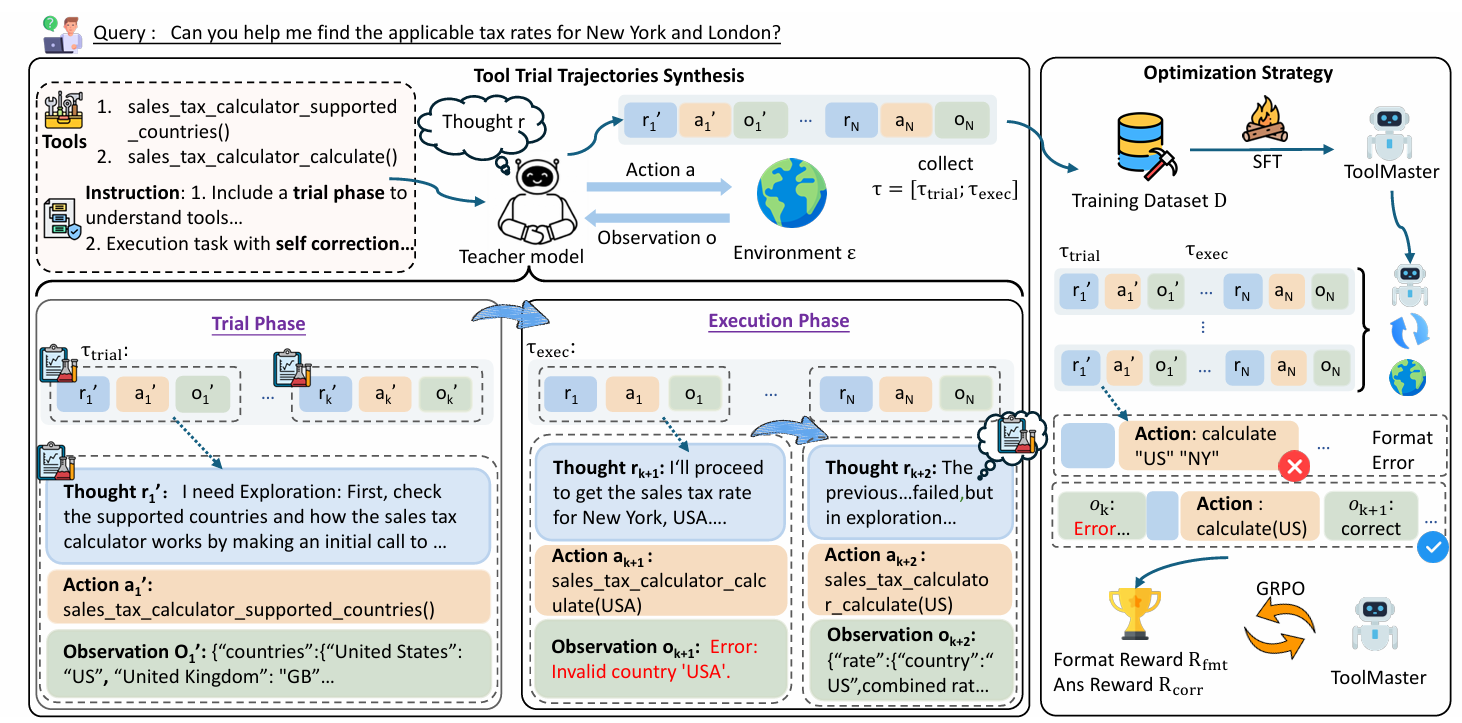
Teaching LLMs to Learn Tool Trialing and Execution through Environment Interaction
Xingjie Gao*, Pengcheng Huang*, Zhenghao Liu†, Yukun Yan, Shuo Wang, Zulong Chen, Chen Qian, Ge Yu, Yu Gu
arXiv代码项目页工具泛化案例预印本全文(HTML)BibTeX
展开摘要
- 本文提出 ToolMaster,通过将被动模仿专家轨迹转变为主动试错执行的范式,使大语言模型在与环境的直接交互中学习探索和自我纠正,从而掌握复杂工具使用。
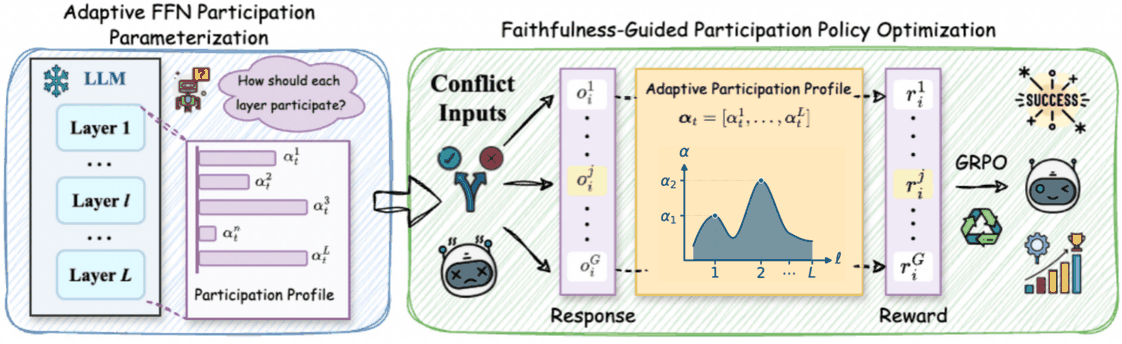
SPARK: Adaptive Parametric Knowledge Participation for Faithful Retrieval-Augmented Generation
Ruochang Li*, Pengcheng Huang*, Zhenghao Liu†, Yukun Yan, Huiyuan Xie, Yu Gu, Ge Yu, Maosong Sun
arXiv代码项目页知识冲突导读(英文)RAG 知识冲突案例预印本全文(HTML)BibTeX
展开摘要
- 本文提出 SPARK(arXiv 初版名为 SHIFT),把 RAG 中参数知识的调控建模为隐式参与策略学习:一个用忠实度奖励训练的轻量策略,动态调节 FFN 中参数知识在生成时的参与程度,主干模型保持冻结,仅新增 0.01% 可训练参数,在六个数据集上生成更忠实。
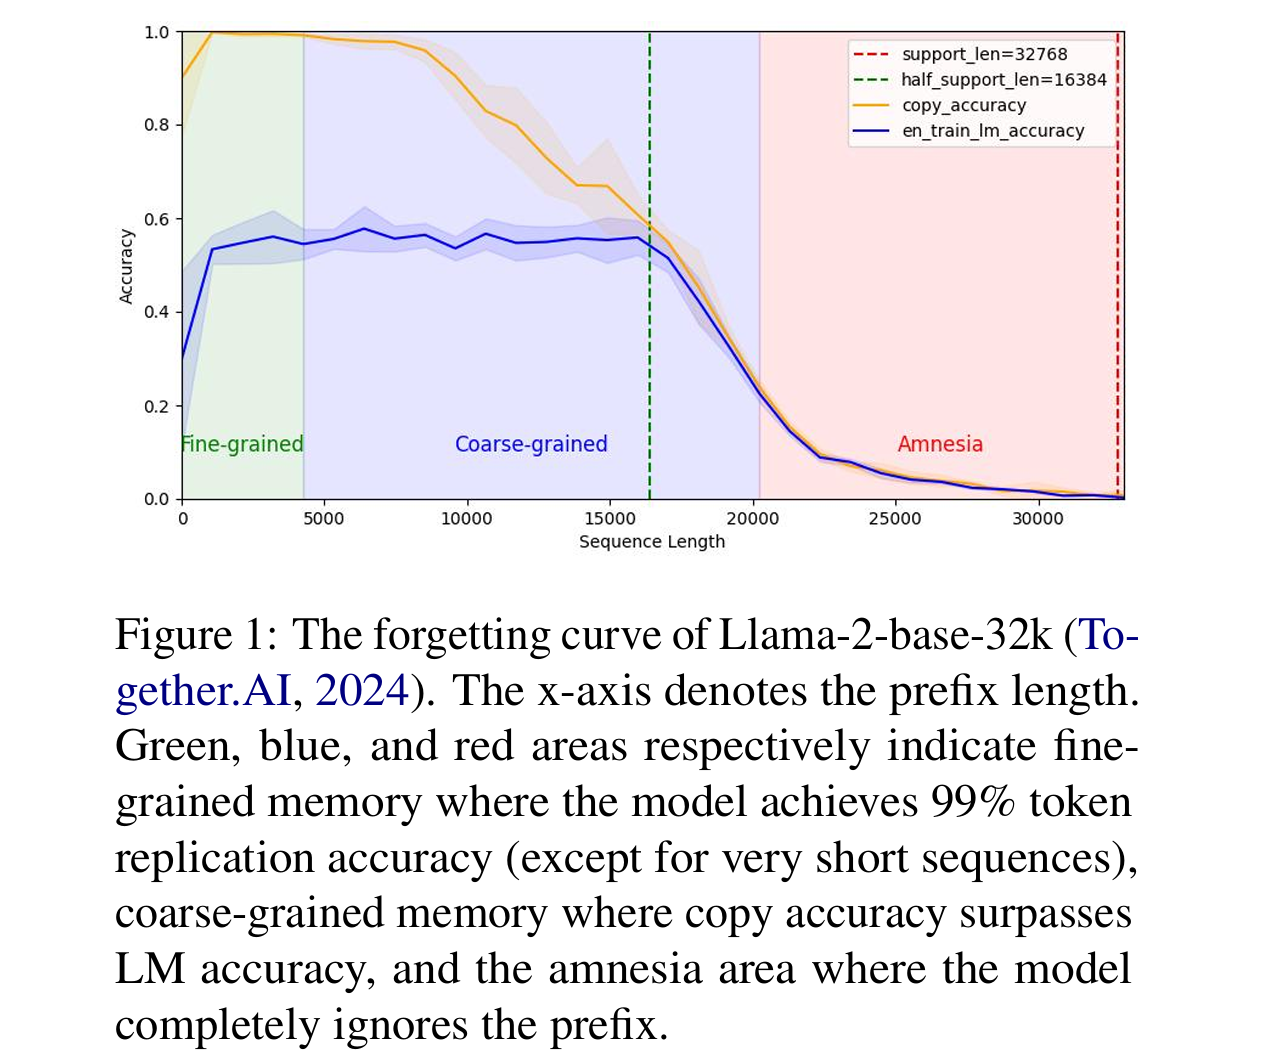
Forgetting curve: A reliable method for evaluating memorization capability for long-context models
Xinyu Liu, Runsong Zhao, Pengcheng Huang, Chunyang Xiao, Bei Li, Jingang Wang, Tong Xiao†, Jingbo Zhu
展开摘要
- 本文发现现有长上下文模型的记忆能力评估方法(如困惑度、”大海捞针”任务)不够可靠,提出遗忘曲线——一种基于拷贝准确率与语言模型准确率对比的无提示鲁棒指标,更忠实地衡量模型对长上下文的记忆能力。
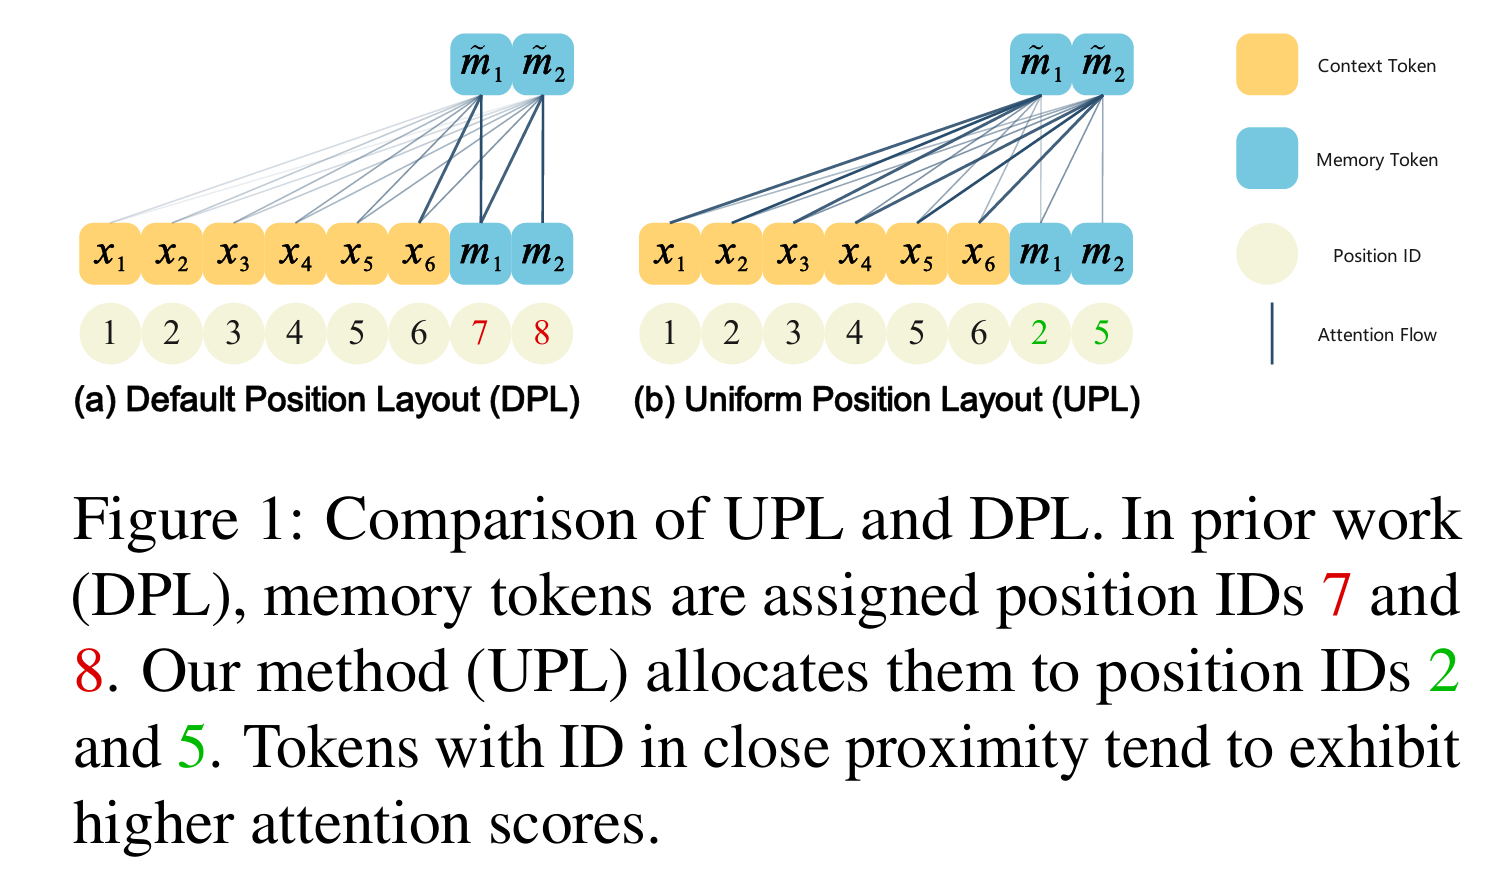
Position IDs Matter: An Enhanced Position Layout for Efficient Context Compression in Large Language Models
Runsong Zhao, Xin Liu, Xinyu Liu, Pengcheng Huang, Chunyang Xiao, Tong Xiao†, Jingbo Zhu
展开摘要
- 本文发现现有 LLM 上下文压缩方法(如 ICAE)在压缩词的位置编码布局上存在缺陷,提出将位置标识符均匀分布并引入专注记忆的”压缩损失”,将压缩比从 4 倍提升至约 15 倍,同时保持重建和下游任务性能。
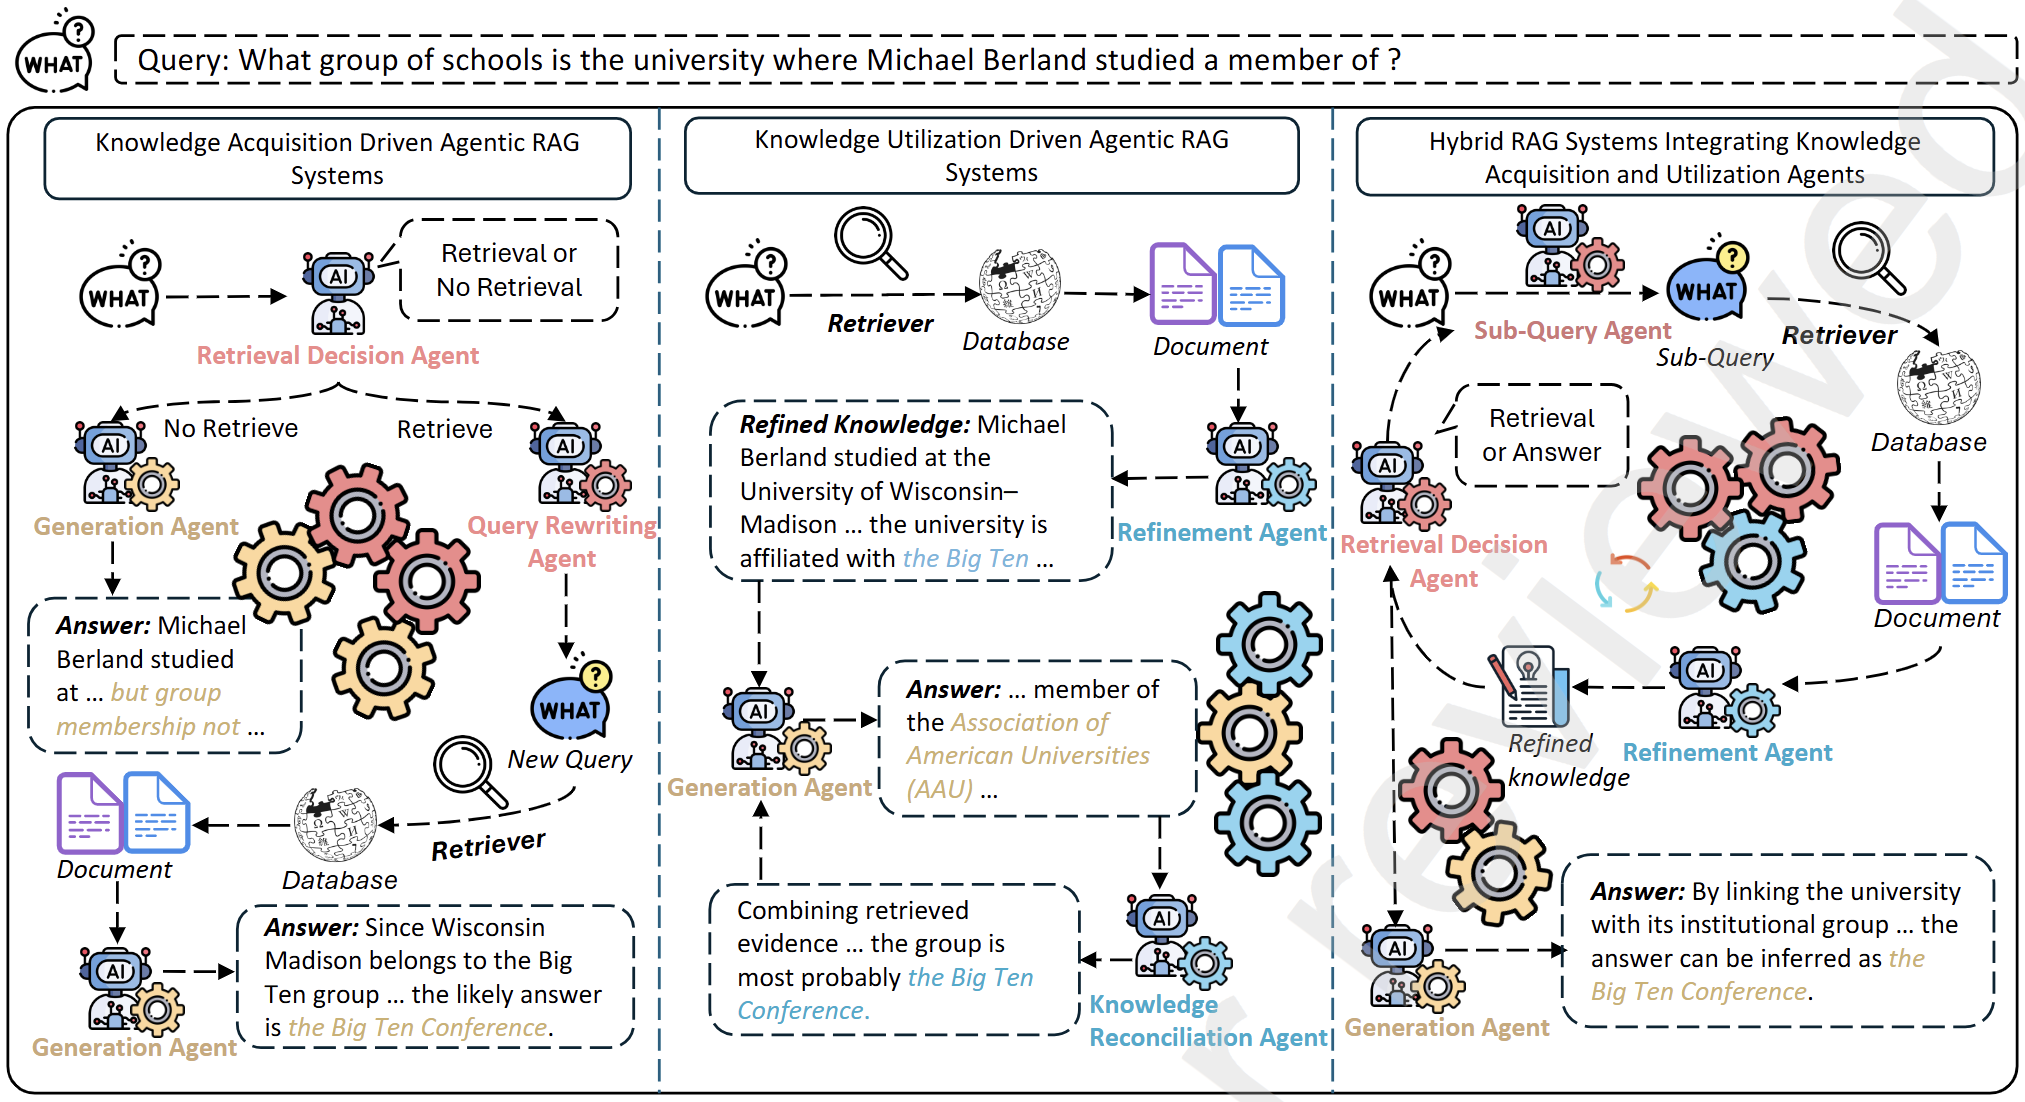
Knowledge Intensive Agents
Zhenghao Liu†, Pengcheng Huang, Zhipeng Xu, Xinze Li, Shuliang Liu, Chunyi Peng, Haidong Xin, Yukun Yan, Shuo Wang, Xu Han, Zhiyuan Liu, Maosong Sun, Yu Gu, Ge Yu
展开摘要
- 本文从智能体视角对检索增强生成进行了全面综述,将知识密集型智能体分为知识获取和知识利用两类角色,并指出多智能体 RAG 系统联合优化的未来方向。
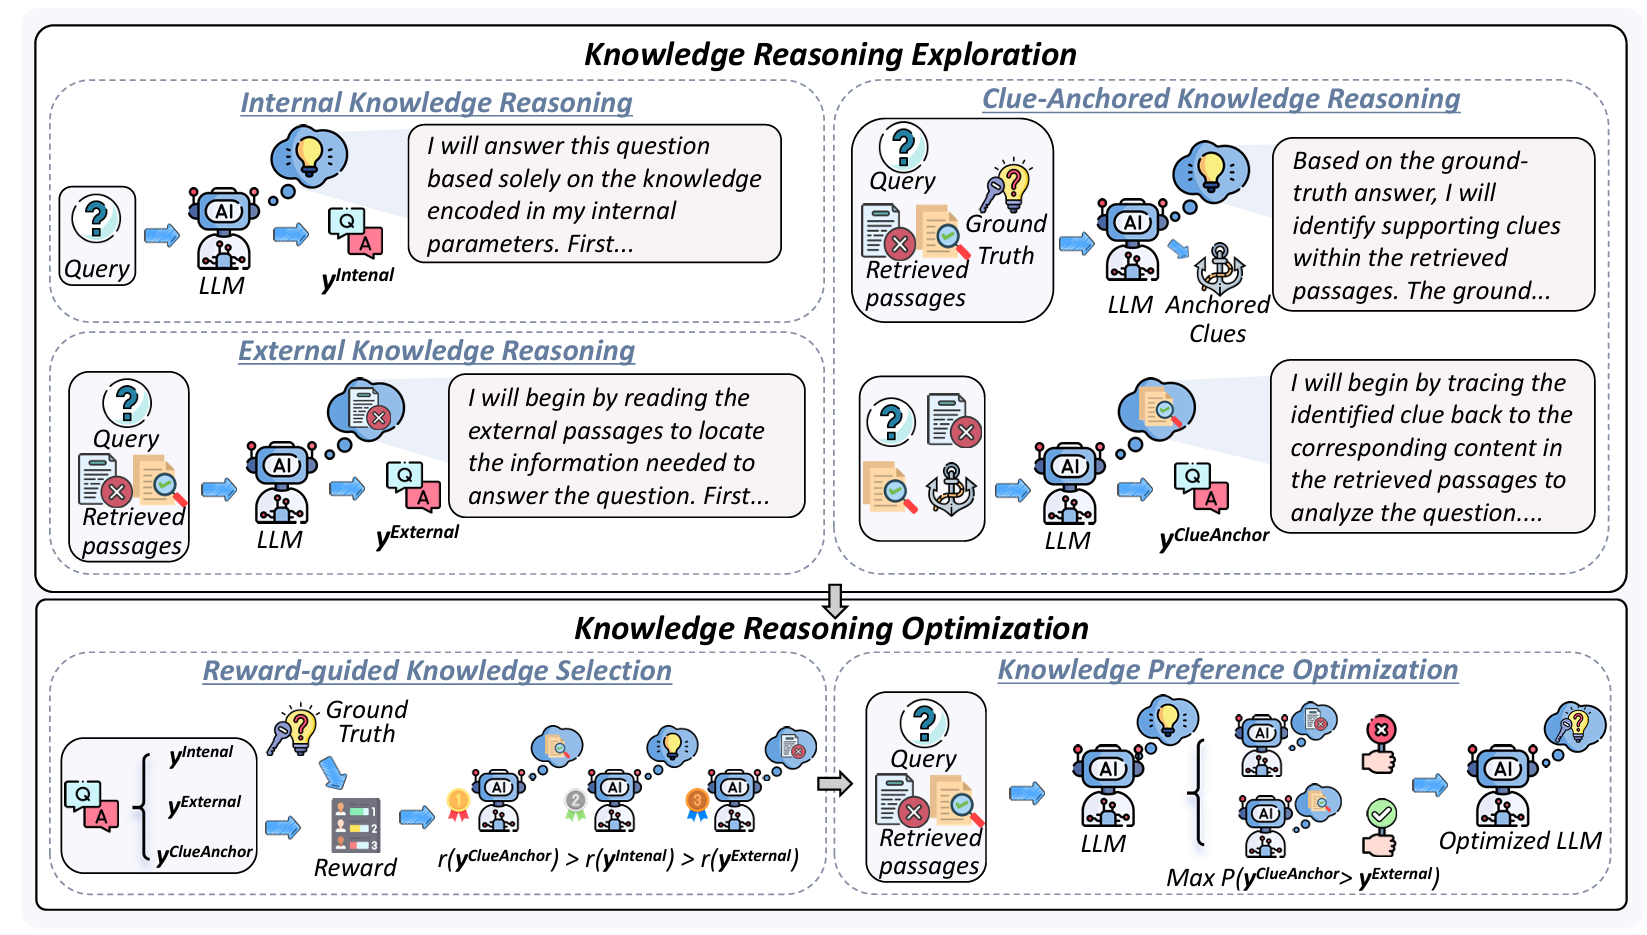
ClueAnchor: Clue-Anchored Knowledge Reasoning Exploration and Optimization for Retrieval-Augmented Generation
Hao Chen, Yukun Yan, Sen Mei, Wanxiang Che, Zhenghao Liu, Qi Shi, Xinze Li, Yuchun Fan, Pengcheng Huang, Qiushi Xiong, Zhiyuan Liu, Maosong Sun
展开摘要
- 本文发现 RAG 系统常因关键证据隐含、分散或被噪声掩盖而未能充分利用检索文档,ClueAnchor 通过提取关键线索、在不同知识配置下生成多条推理路径,再通过基于奖励的偏好优化选择最优路径,显著提升推理完整性和鲁棒性。
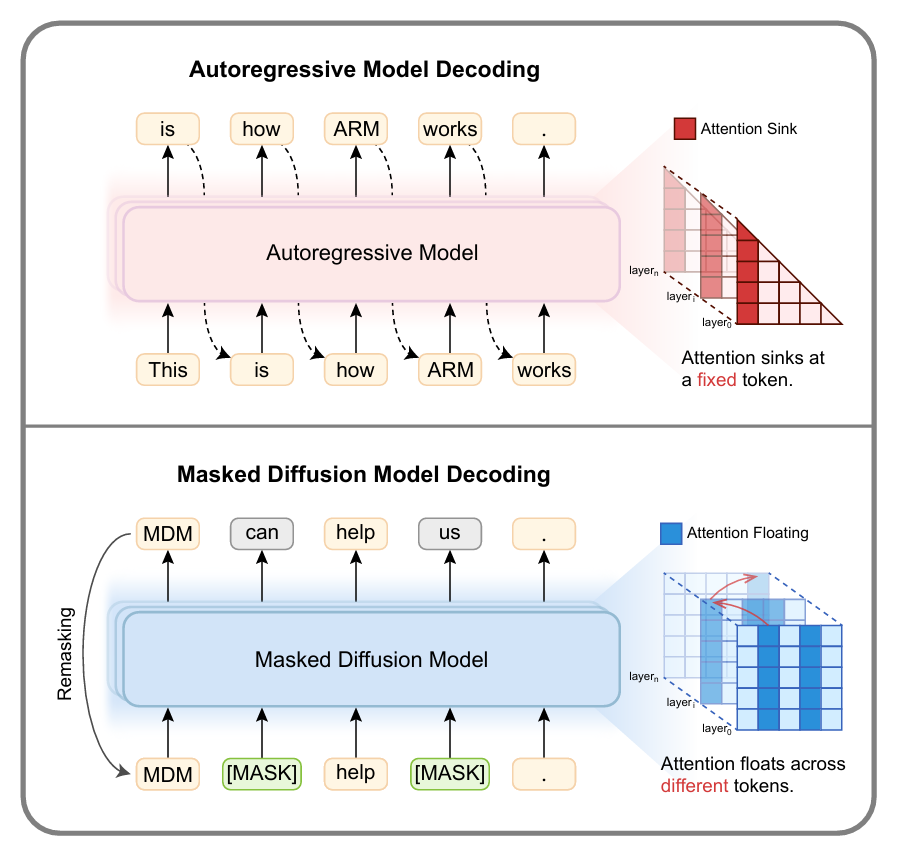
Revealing the Attention Floating Mechanism in Masked Diffusion Models
Xin Dai, Pengcheng Huang, Zhenghao Liu†, Shuo Wang, Yukun Yan, Chaojun Xiao, Yu Gu, Ge Yu, Maosong Sun
展开摘要
- 本文研究了掩码扩散模型的内部注意力行为,发现了独特的”注意力漂浮”机制——注意力锚点在层和去噪步之间动态漂移,为其优于自回归模型的上下文学习能力提供了机理层面的解释。
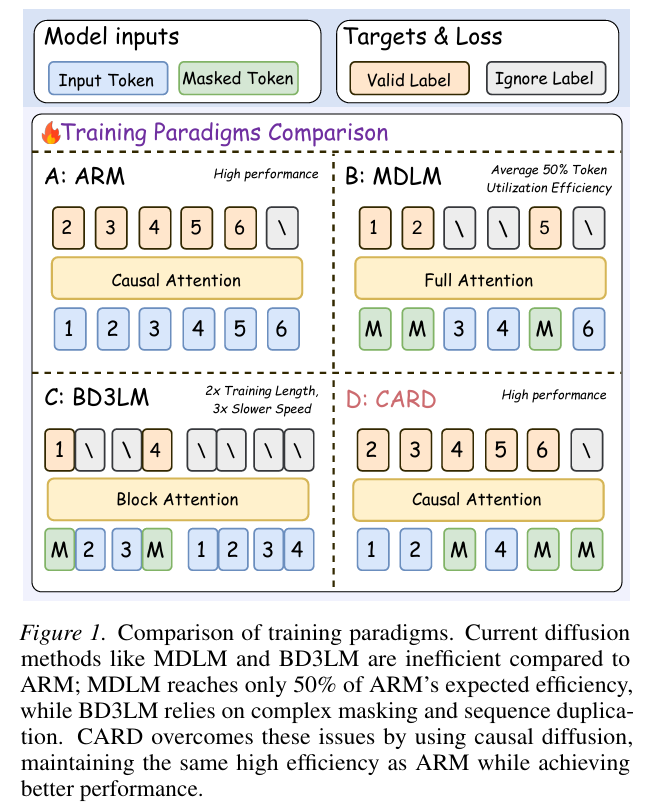
Causal Autoregressive Diffusion Language Model
Junhao Ruan, Bei Li, Yongjing Yin, Pengcheng Huang, Xin Chen, Jingang Wang, Xunliang Cai, Tong Xiao†, JingBo Zhu
展开摘要
- 本文提出因果自回归扩散模型(CARD),通过严格的因果注意力掩码和动态解码机制,将自回归模型的训练效率与扩散模型的高吞吐并行推理统一在一个框架中。
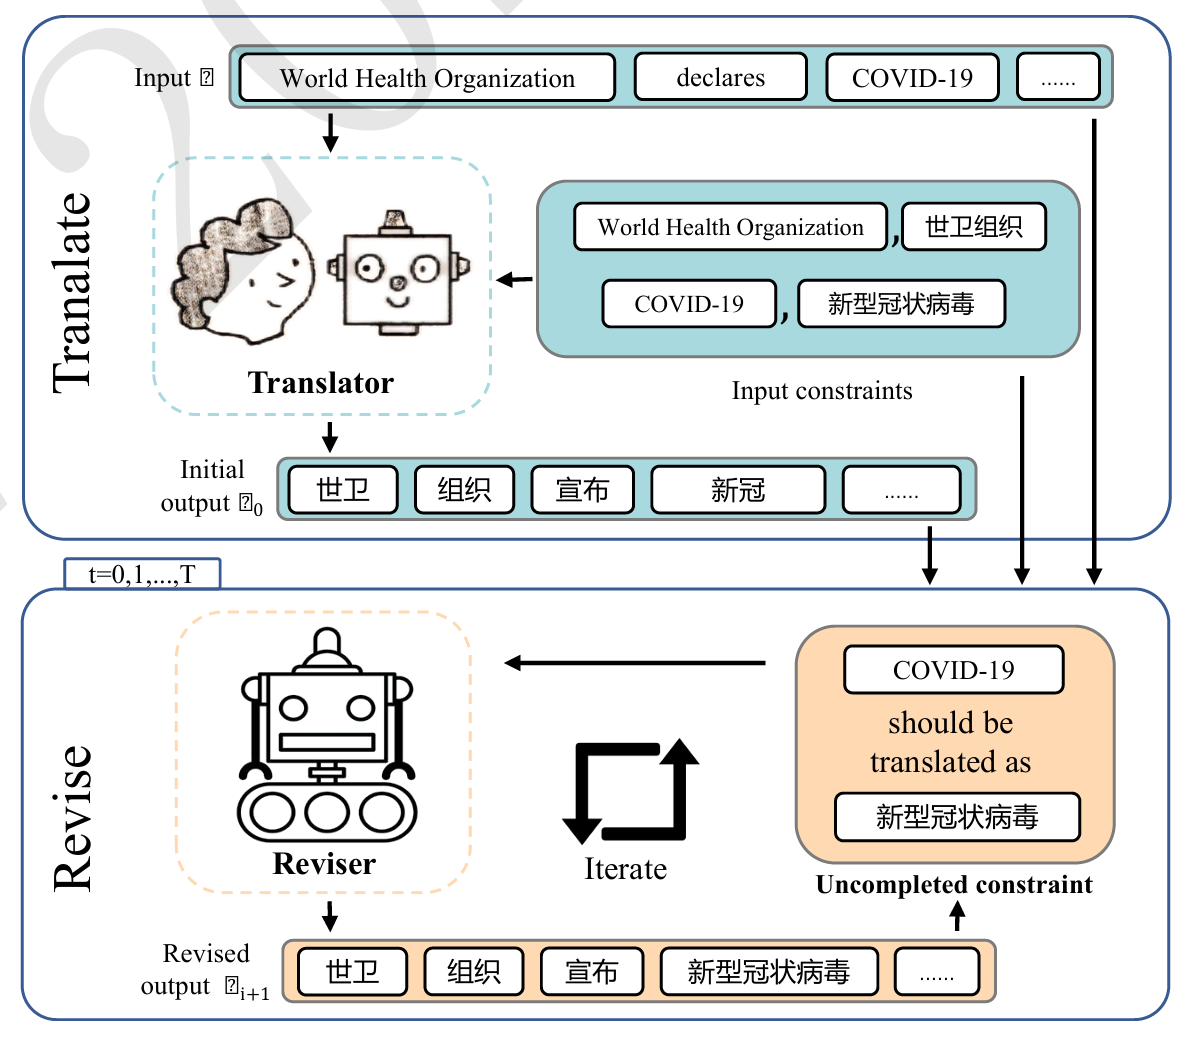
Translate-and-Revise: Boosting Large Language Models for Constrained Translation
Pengcheng Huang, Yongyu Mu, Yuzhang Wu, Bei Li, Chunyang Xiao, Tong Xiao†, Jingbo Zhu
arXivCCL 2024项目主页试用术语检查预印本全文(HTML)Springer 版 BibTeX
展开摘要
- 本文发现大语言模型在约束翻译中常忽略或违反指定的词汇或结构约束,提出 Translate-and-Revise,通过添加修订过程让模型识别未满足的约束并修正输出,约束翻译准确率提升约 15%,超越神经机器翻译基线。
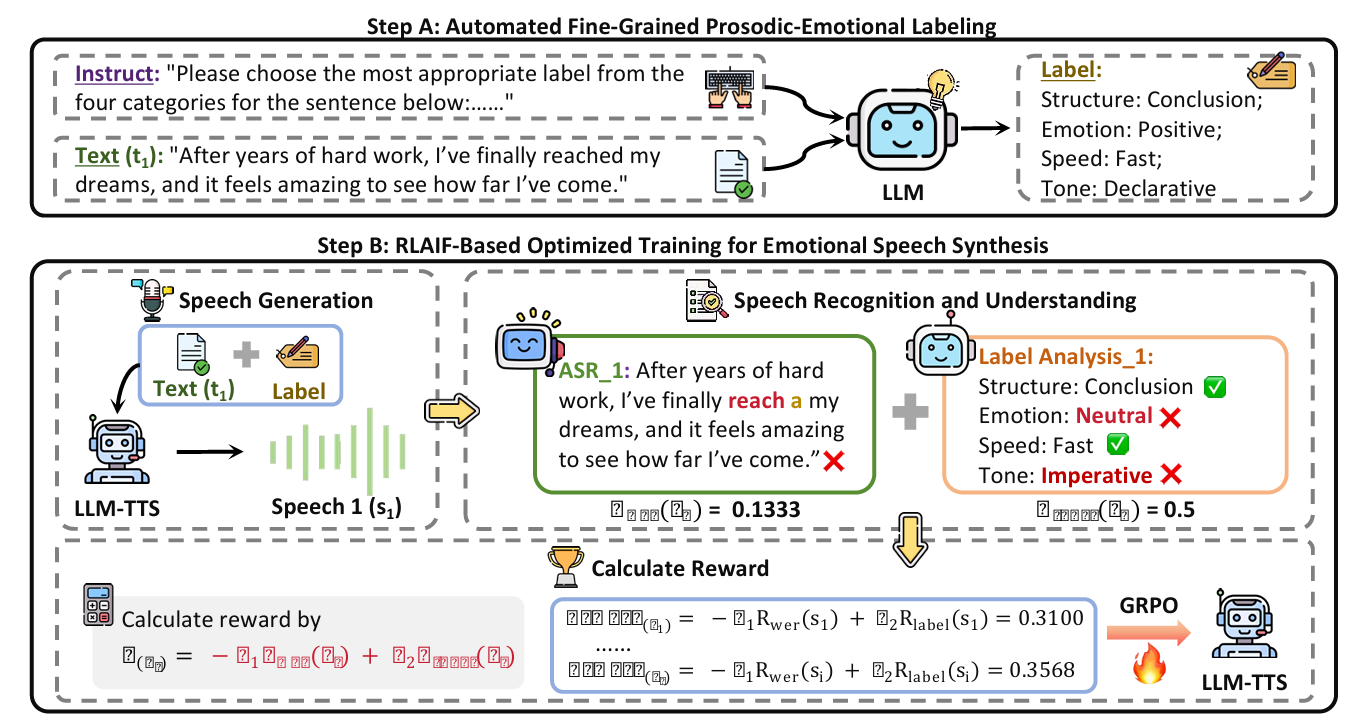
RLAIF-SPA: Optimizing LLM-based Emotional Speech Synthesis via RLAIF
Qing Yang, Zhenghao Liu†, Junxin Wang, Yangfan Du, Pengcheng Huang, Tong Xiao
展开摘要
- 本文提出 RLAIF-SPA,通过基于 AI 反馈的强化学习优化语义准确性和细粒度韵律对齐,提升大语言模型语音合成的情感表现力和韵律自然度。
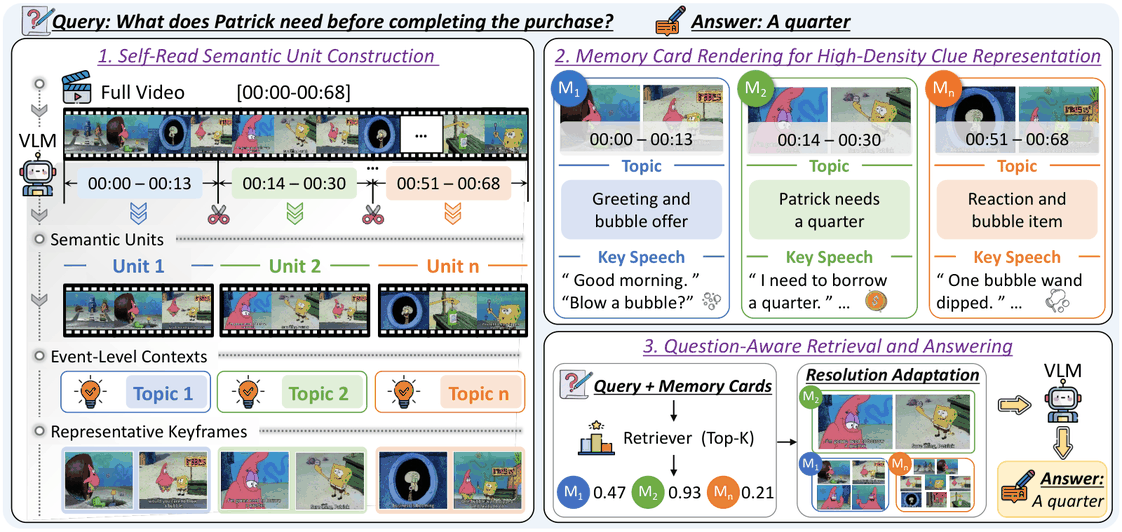
MemoryCard: Topic-Aware Multi-Modal Clue Compression for Long-Video Question Answering
Qing Yang, Pengcheng Huang, Xinze Li, Zhenghao Liu†, Yukun Yan, Yu Gu, Ge Yu, Gang Li, Maosong Sun
展开摘要
- 本文提出 MemoryCard,对长视频及其对齐字幕进行“自读”,按话题或事件切分为语义完整的单元,并为每个单元生成事件级摘要和代表性画面,渲染成统一的记忆卡片用于检索与问答;在相近的视觉 token 预算下,长视频问答准确率相对提升最高 21.8%。
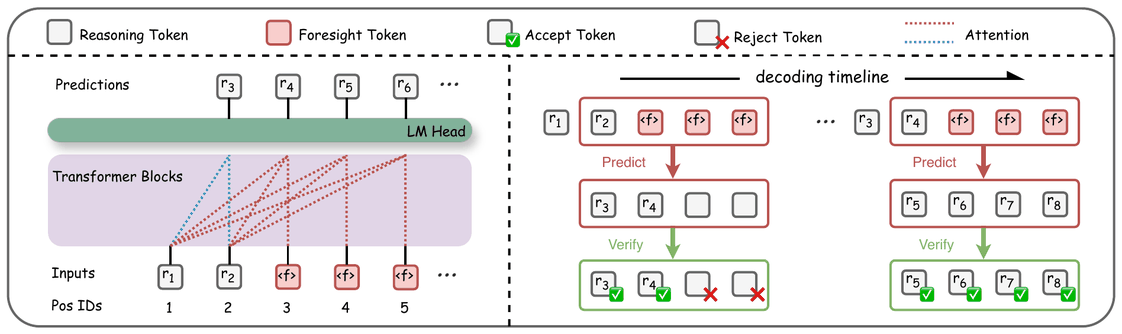
MemoSight: Unifying Context Compression and Multi Token Prediction for Reasoning Acceleration
Xinyu Liu, Xin Liu, Bo Jin, Runsong Zhao, Pengcheng Huang, Junhao Ruan, Bei Li, Chunyang Xiao, Chenglong Wang, Tong Xiao, Jingbo Zhu
展开摘要
- 本文提出 MemoSight,用统一的特殊 token 设计和针对性的位置布局,把上下文压缩(记忆 token)和多 token 预测(前瞻 token)结合在一个框架中;在四个推理基准上 KV 缓存最多减少 66%,推理速度提升 56%,平均准确率下降不到 3%。
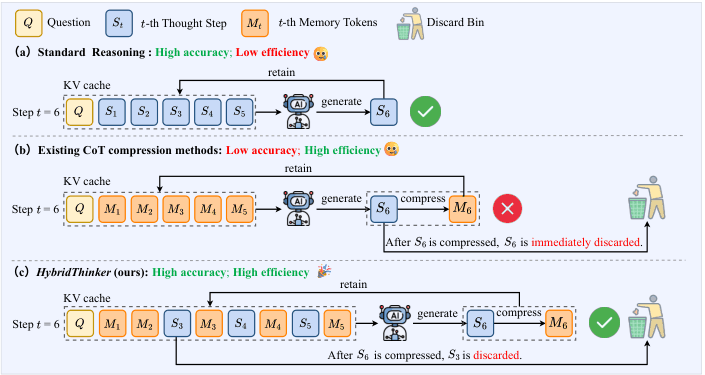
HybridThinker: Efficient Chain-of-Thought Reasoning via Compressed Memory and Transient Thought Steps
Xin Liu*, Runsong Zhao*, Xinyu Liu, Junhao Ruan, Pengcheng Huang, Shichao Dong, Chunyang Xiao, Chenglong Wang, Changliang Li, Jingbo Zhu, Tong Xiao†
展开摘要
- 本文提出 HybridThinker,在把思维链步骤压缩为记忆 token 的同时临时保留原始步骤以提供细粒度信息,并用混合注意力训练方案遮蔽部分步骤,迫使模型通过记忆 token 完成压缩与检索;在 4 个推理基准上与不压缩的基线持平,平均准确率比已有思维链压缩方法高 5.8 个点。